Sanad سند
Un RAG agentique qui montre la page d’où vient sa réponse
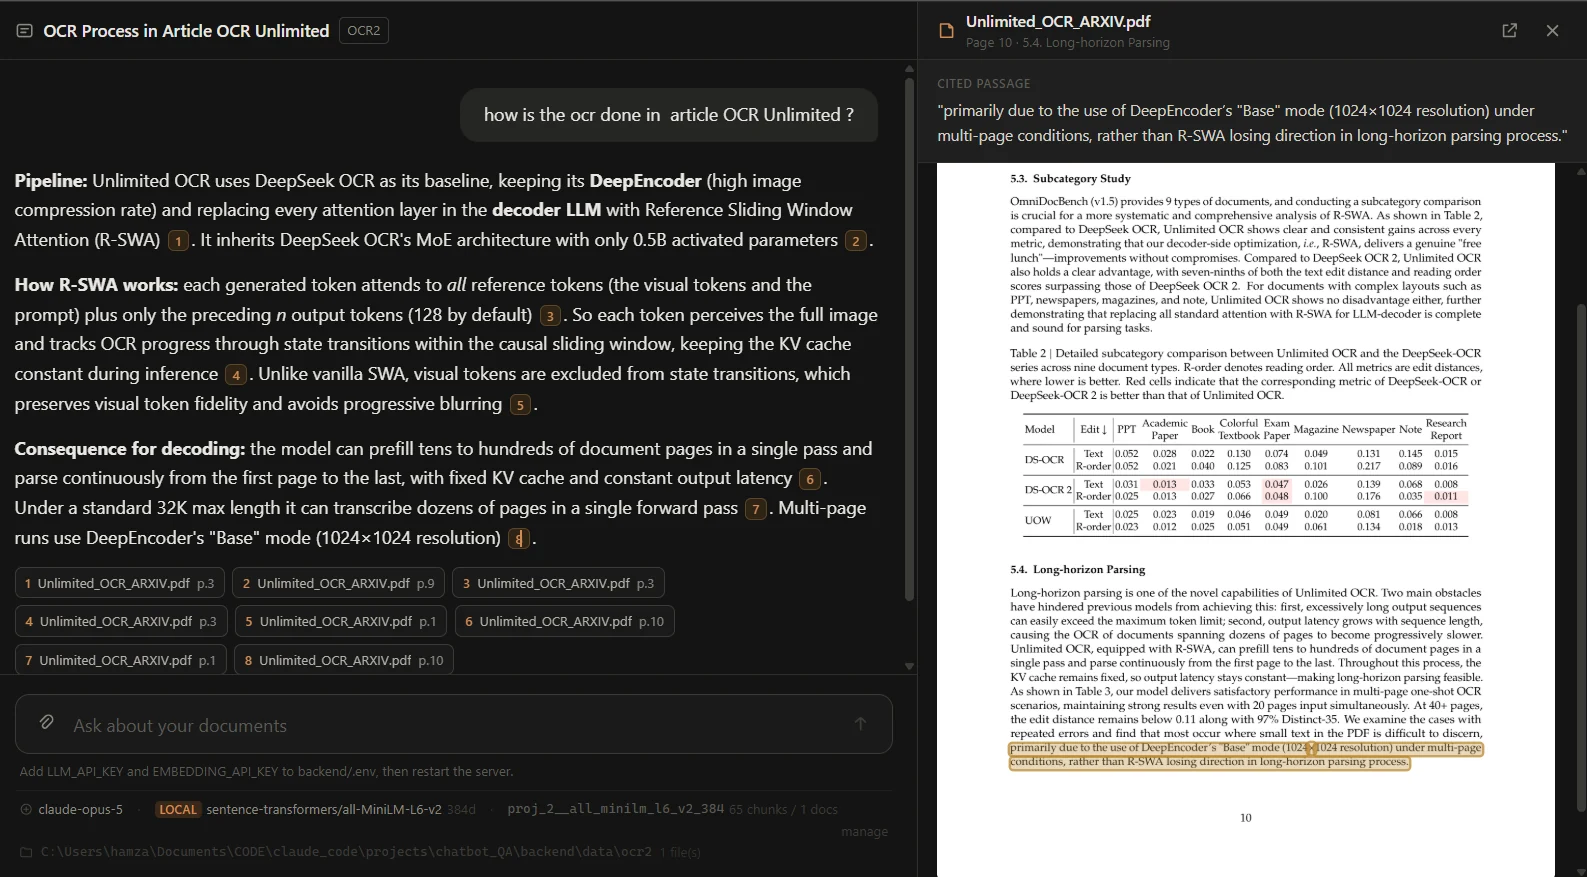
Sanad répond à des questions sur un dossier de documents. Chaque affirmation d’une réponse porte un marqueur, et chaque marqueur renvoie à une page et à une boîte englobante (ou à un bloc et à des offsets de caractères) : un clic, et le fichier d’origine s’ouvre avec le passage exact surligné. Quand les documents ne contiennent pas la réponse, l’agent le dit au lieu de deviner.
- Type
- Projet personnel, 2026, conçu et réalisé de bout en bout
- Formats lus
- PDF, DOCX, PPTX, XLSX, HTML, Markdown, texte, JSON et images
- Backend
- Python, FastAPI, LangGraph, ChromaDB, SQLite FTS5, PyMuPDF, SQLModel
- Modèles
- Claude pour les réponses et l’OCR par vision ; embeddings OpenAI ou locaux (BGE, E5, MiniLM)
- Frontend
- Angular, avec une trace de recherche en direct et une visionneuse de sources PDF/HTML
- Tests
- Plus de 350 tests pytest hors ligne
Le nom
سَنَد, sanad, de la racine س-ن-د, « s’appuyer » : ce sur quoi repose une affirmation. Le mot a trois sens, et le projet se tient à leur croisement.
- Un appui
- Ce qui soutient quelque chose. Une réponse qui ne repose sur rien n’est qu’une phrase plausible.
- Une chaîne de transmission
- Dans la tradition savante islamique classique, le sanad est la chaîne de transmetteurs attachée à un récit. On jugeait un récit selon que sa chaîne remontait ou non à une source, pas selon sa force de conviction. C’est le contrat de ce système : chaque affirmation porte un marqueur, chaque marqueur renvoie à une page, et un extrait introuvable dans le passage qu’il cite est signalé.
- Une pièce justificative
- En arabe commercial, un sanad est le document qui atteste une transaction : سند التسليم, un bon de livraison ; سند الطلب, un bon de commande. Exactement les papiers que Sanad a été conçu pour lire.
Comment un document devient interrogeable
Chaque fichier du dossier d’un projet passe par le même pipeline, quel que soit son format. Suivez un bon de livraison photographié.
- Entrée ou sortie
- Appel LLM
- Code
- Stockage
- Nouveau fichier Un bon de livraison photographié arrive dans le dossier du projet ; le watcher le met en file d’attente.
- Parsing en blocs C’est une image : le parseur la confie donc à la vision.
- OCR par vision La vision de Claude transcrit le bon et le décrit : une photo devient ainsi un document comme un autre.
- Parsing en blocs Retour sous forme de blocs, titres, tableaux et enregistrements conservés. Les fichiers non PDF sont aussi rendus en HTML, avec un identifiant stable par bloc, pour la visionneuse.
- Découpage Titres et enregistrements ouvrent de nouveaux chunks ; le texte est regroupé par blocs d’environ 700 tokens avec 15 % de recouvrement, et une ligne de tableau n’est jamais coupée en deux.
- Contextualisation Un modèle peu coûteux rédige une ou deux phrases qui situent chaque chunk dans son document, pour l’embedding uniquement. Mis en cache par hash de fichier.
- Embedding Vectorisé avec le modèle du projet ; le même texte va dans SQLite FTS5 pour la recherche par mots-clés.
- ChromaDB Stocké dans la collection propre à ce projet et à ce modèle : les espaces vectoriels ne se mélangent donc jamais. Un traitement mis en pause reprend au chunk où il s’était arrêté.
Cette requête ne passe pas par ici. Les autres chemins sont listés plus bas.
Voilà toute la requête. Envie de voir tourner quelque chose de ce genre sur vos données ?
Sélectionnez une case du schéma, ou suivez la requête étape par étape.
-
Ramener tous les formats à un seul type de bloc
PDF, Word, PowerPoint (notes du présentateur comprises), Excel, pages web enregistrées, Markdown, JSON et images deviennent tous le même type de bloc, en conservant titres, tableaux et enregistrements. Les scans et les photos passent par la vision de Claude, qui les transcrit et les décrit : un bon de livraison photographié devient un document comme un autre.
-
Découper selon la structure, puis selon les tokens
Titres, feuilles et enregistrements ouvrent d’abord de nouveaux chunks ; le texte est ensuite regroupé par blocs d’environ 700 tokens, avec un recouvrement de 15 % qui ne coupe jamais une phrase. Un tableau forme toujours un chunk à part ; s’il est grand, il est découpé par lignes et son en-tête est répété dans chaque partie, si bien qu’aucune ligne n’est jamais coupée en deux.
-
Situer chaque chunk dans son document
Contextual Retrieval : un modèle peu coûteux rédige une ou deux phrases qui situent chaque chunk dans son document. Elles sont ajoutées en tête du seul texte vectorisé, jamais de ce que voit l’utilisateur ni de ce à quoi un extrait cité est comparé. Une ligne comme « | 80 | 6.00 | 480.00 | » devient trouvable par une question sur le prix des accessoires. Le résultat est mis en cache par hash de fichier : une réingestion ne coûte rien.
-
Un seul rendu, des citations durables
Tout fichier non PDF est converti à l’ingestion en HTML, avec un identifiant stable sur chaque paragraphe, ligne et enregistrement. La visionneuse n’a alors que deux cas à gérer, PDF et HTML, et les offsets de caractères d’un chunk coïncident avec le rendu, puisque les deux proviennent du même parsing.
-
Alimenter deux index
Les vecteurs vont dans ChromaDB, à raison d’une collection par projet et par modèle d’embedding : changer de modèle ne mélange donc jamais les espaces vectoriels. Le même texte va dans SQLite FTS5 pour la recherche par mots-clés.
-
Garder l’index fidèle au dossier
Chaque projet possède un dossier. Un watcher ingère les fichiers dès qu’ils apparaissent, un réconciliateur rescanne le dossier au démarrage, et une barre de progression suit chaque fichier à travers le parsing, le découpage, la contextualisation et l’embedding. Un fichier, ou toute la file d’attente, peut être mis en pause puis repris au chunk où il s’était arrêté, sans qu’aucun appel de vision ou de LLM soit payé deux fois, même après un redémarrage.
Deux recherches, un seul classement
Les embeddings généralisent mais ratent les chaînes exactes ; une question sur une référence de pièce, un total de facture ou un code comme VT-COB/SKU98496 est lexicale. BM25 traite celles-là, les embeddings traitent « qu’a conclu le rapport sur la croissance ». Les deux tournent à chaque recherche.
La similarité cosinus et les scores BM25 vivent sur des échelles incompatibles ; ils sont donc fusionnés par Reciprocal Rank Fusion, qui n’a besoin que des rangs : rien à calibrer par corpus, et le résultat reste correct quand l’un des deux moteurs ne renvoie rien. Un cross-encoder lit ensuite chacun des 20 candidats avec la question, ce qui est bien plus précis et n’est abordable que sur une liste courte. Le modèle reçoit la section parente de chaque chunk : le chunk est ce qui a été trouvé, la section est ce qui répond.
Les embeddings retrouvent les passages de même sens, même formulés autrement.
Les 6 passages retenus sont envoyés au modèle avec leur section parente, chacun étiqueté par fichier, page et section pour qu’il puisse les citer.
Un agent qui sait s’abstenir
Un agent LangGraph plutôt qu’un RAG en un seul passage, parce que les questions à plusieurs volets demandent plusieurs recherches, et parce que « j’ai cherché et la réponse n’y est pas » est une conclusion qui mérite d’être atteinte volontairement.
- Entrée ou sortie
- Appel LLM
- Code
- Question « Et la deuxième ? », posée juste après une question sur deux références produit.
- Réécriture S’appuie sur les six derniers tours pour la rendre autonome : « prix unitaire de la référence 40564101 dans produits.xlsx ».
- Plan Classe le tour comme une recherche simple : il n’y a donc rien à décomposer. Un bavardage s’arrêterait ici, sans recherche.
- Agent Le premier tour impose une recherche : le modèle ne peut donc pas répondre de mémoire. Il appelle l’outil de recherche.
- Recherche hybride BM25 et les vecteurs renvoient 30 candidats chacun ; Reciprocal Rank Fusion en garde 20 et le cross-encoder 6, transmis sous la forme de leurs sections parentes.
- Agent Il dispose d’éléments et cesse d’appeler des outils.
- Critique Juge si les éléments trouvés répondent à la question : suffisant.
- Réponse Produit un JSON : la réponse avec un marqueur sur chaque affirmation, et un extrait mot pour mot pour chaque citation.
- Citations ancrées Retrouve chaque extrait dans son chunk (exact, normalisé, puis approximatif) et le convertit en coordonnées de page. En dessous d’un score de 72, il est affiché comme non vérifié.
- Réponse sourcée La réponse, avec une pastille de source par affirmation ; un clic sur l’une d’elles ouvre le fichier avec les lignes citées surlignées.
Cette requête ne passe pas par ici. Les autres chemins sont listés plus bas.
Voilà toute la requête. Envie de voir tourner quelque chose de ce genre sur vos données ?
Sélectionnez une case du schéma, ou suivez la requête étape par étape.
Les autres chemins du graphe
- Bavardage : le nœud de planification aiguille vers une simple réponse et le graphe s’arrête, sans recherche.
- Questions multi-hop et de comparaison : décomposées en 2 à 4 parties, chacune recherchée séparément.
- Les outils ont tourné sans rien trouver : l’agent relance une recherche avec une autre formulation.
- La critique juge les éléments insuffisants : retour à l’agent avec une meilleure requête, 3 tours au maximum en tout.
- Le modèle cesse d’appeler des outils, atteint la limite de tours ou échoue : passage direct à la réponse, qui dit ce qui manque.
Le nœud de réponse renvoie un JSON structuré. Chaque affirmation porte un marqueur, et chaque citation est recopiée caractère pour caractère afin d’être retrouvée :
{
  "answer_markdown": "Le total est 82 900,00 DH [1], conforme au bon de livraison [2].",
  "citations": [
    { "marker": 1, "source": 1, "quote": "Total : 3 240 unites - 82 900,00 DH" }
  ],
  "sufficient": true
}
Chaque citation est vérifiée
Les modèles citent presque mot pour mot : ils redressent les guillemets, fusionnent les espaces, oublient un point final. Chaque citation est donc localisée dans son chunk source en trois passes, et le score décide de son affichage.
| Passe | Score |
|---|---|
| Sous-chaîne exacte | 100 |
| Sous-chaîne normalisée (espaces, guillemets typographiques, tirets) | 97 |
| Fenêtre glissante approximative, puis affinée | son ratio |
Dans un PDF, la citation devient une page et des boîtes englobantes, en essayant des fragments plus courts quand un saut de ligne s’interpose ; dans tous les autres formats, elle devient un identifiant de bloc et des positions de caractères dans le rendu HTML. Sous un score de 72, le lecteur surligne le chunk entier : un surlignage sûr de lui sur la mauvaise ligne est pire qu’un surlignage vague.
-
Citations vérifiées
Un extrait qui correspond à son chunk avec un score de 72 ou plus est vérifié. En dessous, il s’affiche en ambre, marqué non vérifié, et la réponse reçoit un badge « 2 sources sur 3 vérifiées ». Les citations non vérifiées ne sont jamais supprimées : une correspondance imparfaite est le plus souvent une vraie source légèrement paraphrasée, et la masquer reviendrait à masquer un problème de recherche.
-
Chiffres sans citation
Toute phrase qui avance un chiffre sans marqueur est comptée. Sur des factures et des bons de livraison, un total inventé est l’erreur qui compte, et le seul décompte des citations ne peut pas la voir.
-
Marqueurs orphelins
Un marqueur présent dans le texte sans source correspondante est détecté et journalisé.
Mesuré, pas affirmé
Le banc d’évaluation note la recherche avec recall@k, MRR et nDCG par catégorie, et les réponses complètes sur leur ancrage dans les sources (groundedness) et la justesse des refus. Les exécutions limitées à la recherche n’appellent aucun LLM : comparer six modèles d’embedding ne coûte donc rien. Le jeu de référence contient volontairement des questions sans réponse : un système qui répond à tout obtient un recall parfait et ne sert à rien.
| Méthode | all-MiniLM-L6-v2 | bge-small-en-v1.5 |
|---|---|---|
| Vecteurs seuls | 0,53 | 0,81 |
| BM25 seul | 0,57 | 0,57 |
| Hybride + rerank | 0,94 | 0,94 |
Échelle de 0 à 1 ; plus c’est haut, plus le bon passage est classé près du sommet.
Le tableau montre pourquoi il faut savoir quel étage de la recherche on évalue. À travers le pipeline complet, un modèle d’embedding faible et un fort obtiennent le même score, parce que BM25 et le reranker rattrapent le faible. Pour choisir un modèle d’embedding, on évalue les vecteurs seuls ; pour juger le système, on l’évalue en entier. Les comparaisons se font question par question : une moyenne stable qui masque des écarts dans les deux sens apparaît donc pour ce qu’elle est, une régression.
La catégorie la plus faible est l’agrégation (recall@6 de 0,50, MRR de 0,10 avec MiniLM) : le RAG retrouve des passages, il n’additionne pas trois totaux répartis dans trois fichiers. La solution est un outil de calcul sur les lignes de tableau retrouvées, et le banc d’évaluation existe pour qu’il soit construit sur un chiffre, pas sur une affirmation.
Choix d’ingénierie
-
Les modèles se choisissent à l’exécution
Le modèle d’embedding se choisit par projet (un dossier de bons de livraison en français et en arabe appelle BGE-M3, des documents en anglais s’en sortent mieux avec BGE-base) ; le modèle de réponse est réglé pour toute l’instance. Les deux se changent sans redémarrage, et la réindexation tourne en arrière-plan pendant que le chat continue de répondre avec l’ancien modèle.
-
Les modèles limités à l’anglais sont signalés
Sur de l’arabe ou du français, ils n’échouent pas bruyamment : ils renvoient n’importe quoi avec aplomb. Le sélecteur les signale donc en ambre.
-
Requête et documents partagent le même modèle
Le modèle est résolu une seule fois par requête et sert à la fois à l’embedding et au nom de la collection. Si les métadonnées d’une collection ne concordent pas, la recherche lève une erreur plutôt que de renvoyer de mauvais passages.
-
Un document en pause est invisible
Conserver pendant une pause le travail déjà payé ne doit pas rendre interrogeable la moitié d’un document : les vecteurs attendent donc dans un spool et rejoignent l’index en une seule écriture.
-
Le travail est montré
Chaque recherche affiche ses étapes en direct (embedding, sémantique, mots-clés, fusion, rerank), puis se replie sous la réponse en « comment la réponse a été trouvée », enregistré avec le message.
-
Fonctionne hors ligne
Avec un modèle d’embedding local, l’ingestion et la recherche n’ont besoin d’aucune clé d’API d’embedding ; seule la génération de la réponse appelle un LLM. Chaque appel d’endpoint et chaque action interne sont journalisés en base.
Technologies
- Agent
- LangGraph, appel d’outils, réponses en JSON structuré, checkpoints SQLite, appariement des extraits avec rapidfuzz
- Recherche
- ChromaDB, SQLite FTS5 (BM25), Reciprocal Rank Fusion, bge-reranker-v2-m3
- Ingestion
- PyMuPDF, python-docx / python-pptx / openpyxl, OCR par vision Claude, tiktoken, watchdog
- Backend
- Python, FastAPI, Server-Sent Events, SQLModel, Alembic
- Frontend
- Angular 20 (signals), Tailwind CSS, lecteur Server-Sent Events
- Qualité
- pytest, jeux de questions de référence, recall@k, MRR, nDCG, groundedness
Vous construisez quelque chose de similaire ?
J’échange volontiers sur la recherche dans des documents métier désordonnés, les citations que l’on peut auditer, ou la façon d’évaluer un système RAG avant de lui faire confiance.