Hamza Ouhssaine

Ingénieur IA générative et data scientist senior à Paris. Je conçois des agents LLM et du RAG qui calculent au lieu de deviner, et qui citent leurs sources.

Expérience

L’IA générative pour une banque aujourd’hui, après la vision par ordinateur chez un sidérurgiste et le big data pour le transport aérien. Un dossier par chapitre, le plus récent au-dessus.

BPCE & Natixis

IA générative pour la finance 2026 – aujourd’hui

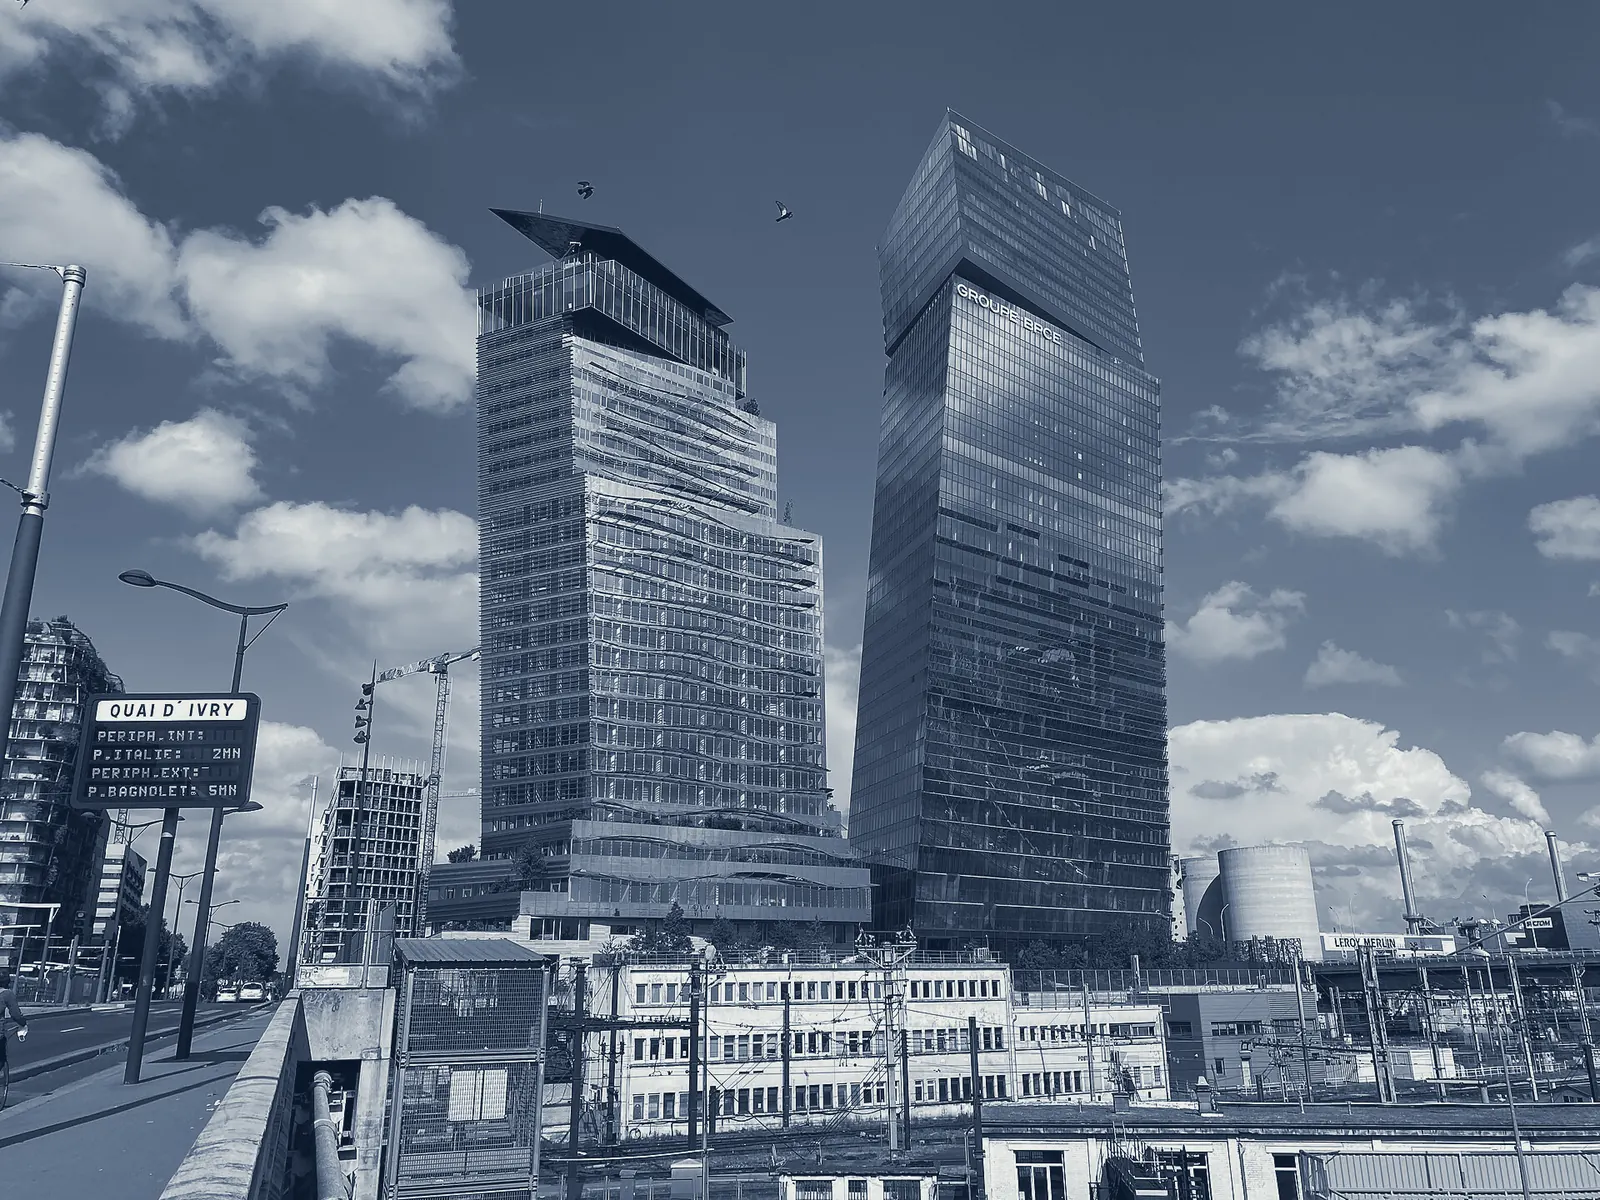
Les deux tours de verre inclinées des Tours Duo à Paris, la plus haute portant l’enseigne Groupe BPCE, au-dessus des voies ferrées.
Tours Duo, Paris 13e, siège de Natixis et du Groupe BPCE.

BPCE & Natixis Data Scientist, GenAI

– aujourd’hui, Paris

  • Steering ALM Metrics. Plateforme qui automatise le suivi et le reporting de la liquidité (LCR) à l’échelle du Groupe BPCE, construite et déployée avec les équipes Trésorerie, ALM et IT pour analyser de grands volumes de données de bilan et expliquer chaque variation. Un agent IA fondé sur un LLM répond aux questions des analystes en langage courant et creuse dans les données.
  • Insight Generator. Plateforme d’analyse de données financières et de business intelligence pour Natixis. Les utilisateurs importent leurs fichiers, les explorent avec des tableaux croisés et des graphiques, puis exportent leurs rapports. Un assistant d’IA générative (LLM, RAG) aide les équipes à en tirer des enseignements et à améliorer la performance métier. Comment fonctionne Insight Generator
  • AAR (Accounting Analytical Review). Application qui fluidifie les revues trimestrielles des comptes sociaux et consolidés pour environ 200 entités de Natixis. Elle rédige un premier jet des analyses de variations significatives des comptes et des sections du rapport au Comité d’audit, que les réviseurs corrigent et valident. Utilisée par les équipes Contrôles permanents et Consolidation pour réduire le travail manuel et standardiser un processus sur lequel s’appuient les décisions de gestion et les audits.
  • Chatbot de politique T&E (APAC). Chatbot d’IA générative (LLM, RAG) pour la politique de déplacements et de frais de représentation (T&E) de la zone APAC. Il automatise les réponses aux questions des collaborateurs, en s’appuyant sur les règles officielles avec des liens vers les sources. Les administrateurs ajoutent des documents, définissent des règles sur mesure et consultent les retours depuis un dashboard dédié.

Outils IA générative, LLM, RAG, LangGraph, LangChain, ChromaDB, Python, Machine Learning, Microsoft Graph API, AngularJS, JavaScript, Docker, Jenkins, OpenShift
ArcelorMittal

Vision par ordinateur sur la ligne d’acier 2022 – 2025

Des bobines d’acier emballées, posées sur la tranche dans une longue halle industrielle, à côté d’un lourd outillage de presse.
Bobines d’acier dans l’entrepôt d’une usine : le type de produit dont le pipeline de vision lit les identifiants.

ArcelorMittal Data Scientist

– , Marseille

  • Reconnaissance des identifiants produits. Pipelines de vision par ordinateur qui lisent les identifiants des produits sidérurgiques avec un taux d’erreur par caractère de 0,098 %, ce qui réduit les contrôles manuels et améliore la traçabilité.
  • Modèles prédictifs pour la production d’acier. Modèles de pilotage du refroidissement qui fiabilisent la production, et détection de défauts par vision par ordinateur sur les rouleaux de coulée et les produits, intégrés avec des équipes pluridisciplinaires pour réduire l’inspection manuelle.
  • MLOps sur Google Cloud. Mise en place de bout en bout de la partie Vertex AI (Workbench, entraînement personnalisé, Pipelines, Model Registry, prédiction en ligne et par lots, RAG avec Gemini) pour l’OCR des identifiants produits, la détection de défauts et un assistant LLM/RAG, dans une architecture hybride : inférence temps réel dans l’usine, entraînement et traitements batch sur GCP.

Outils Python, PyTorch, Deep Learning, Vision par ordinateur, OpenCV, Traitement d’image, LLM, RAG, Vertex AI, Elasticsearch, Kibana, Dataiku, Sciences de la décision

Amadeus

Big data pour les compagnies aériennes 2021 – 2022

Un tableau des départs d’aéroport à palettes affichant des vols pour Singapour, Auckland, Los Angeles, Bangkok, Hong Kong et Kuala Lumpur.
Un tableau des départs : les sièges dont le revenue management des compagnies aériennes fixe le prix.

Amadeus Ingénieur Big Data

– , Nice

  • Conception et maintenance de pipelines ETL de production sur de grands volumes de données de compagnies aériennes pour le Revenue Management, avec tests et déploiement automatisés.
  • Projets livrés pour Southwest, Polish Airlines, Singapore Airlines et Kuwait Airways ; team leader, en charge du recrutement de l’équipe.
Meelo · CRIStAL

Recherche et premiers modèles 2019 – 2020

Meelo Data Scientist stagiaire

– , Lille

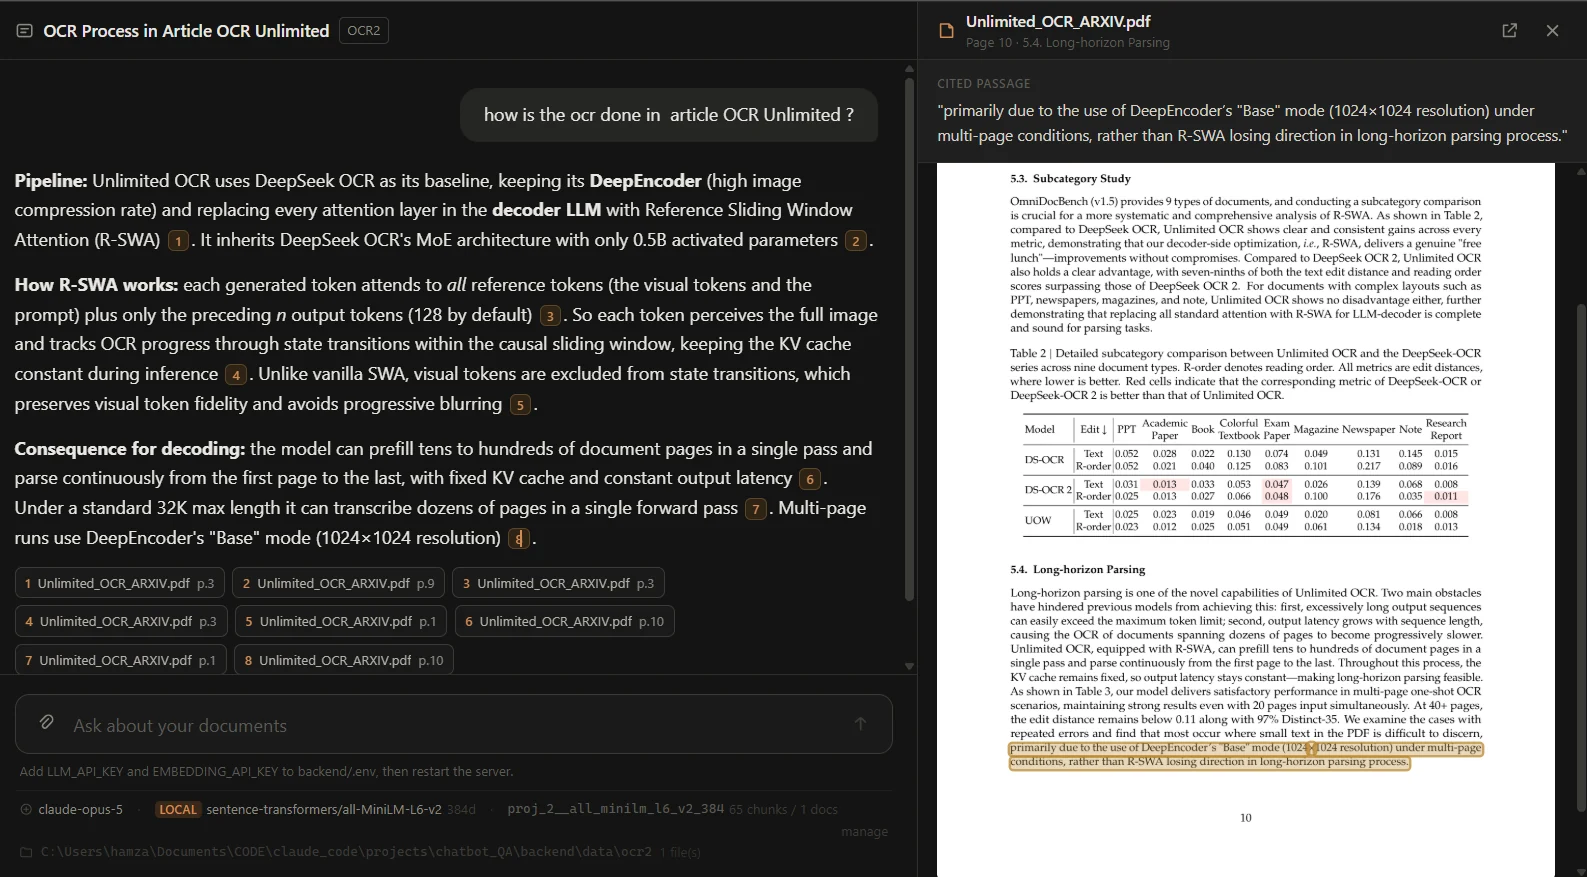
  • Reconnaissance optique de caractères sur des documents administratifs spécifiques, avec un OCR de documents à l’état de l’art fondé sur des réseaux LSTM, CNN et Transformer.
  • Une API qui reconnaît les liasses fiscales des entreprises et calcule leur score financier.
  • Détection de la fraude et des impayés pour le crédit à la consommation, par machine learning sur les données ouvertes de l’INSEE.
  • Maintenance corrective des modèles de prédiction en production.

Outils PyTorch, Machine Learning, OCR, LSTM, CNN, Transformers

CRIStAL Lab Chercheur en deep learning

– , Lille

  • Deep learning appliqué à la stéganalyse : détection de messages cachés dans des images avec un réseau résiduel profond, ResNet-12.
  • Élagage de canaux (channel pruning) du ResNet-12 avec CALPA-Net.

Outils PyTorch, Traitement d’image, ResNet, CALPA-Net

Centrale Lille

Mathématiques et ingénierie 2014 – 2020

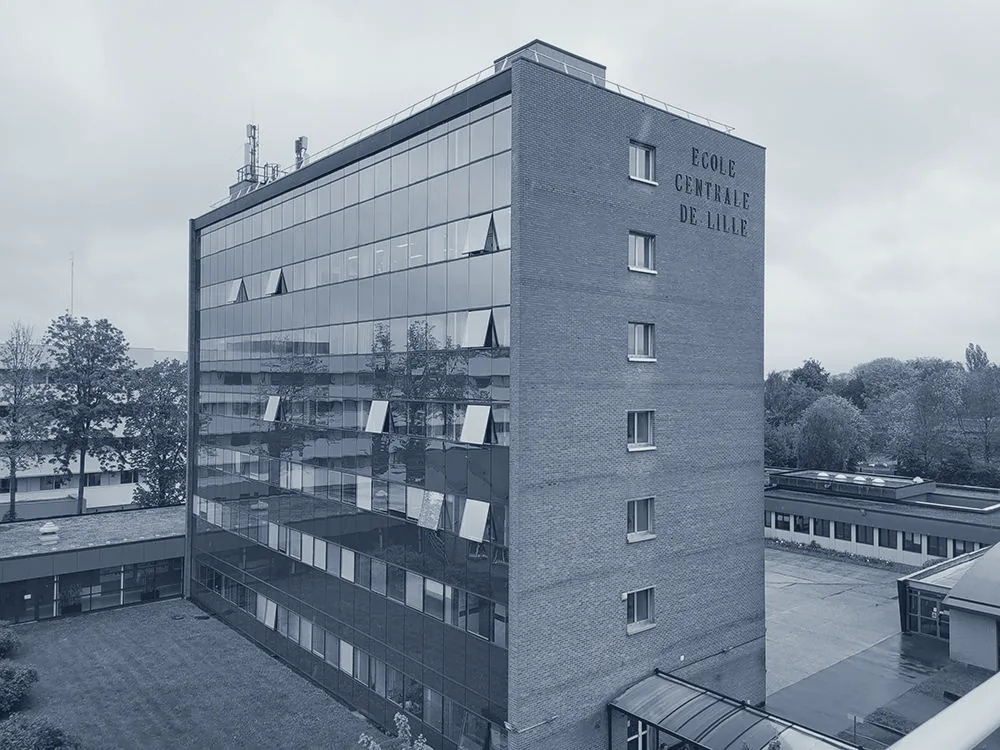
Le bâtiment principal de Centrale Lille, sur le campus de la Cité scientifique : une façade vitrée et un pignon de brique portant l’inscription « ECOLE CENTRALE DE LILLE ».
Centrale Lille, Villeneuve-d’Ascq.

Formation

  1. 2016 – 2020

    Diplôme d’ingénieur, Data Science & IA, Centrale Lille

    Diplôme d’ingénieur (grade de master) de l’une des grandes écoles françaises de premier rang, membre du Groupe des Écoles Centrale : deux ans de formation d’ingénieur généraliste et pluridisciplinaire, puis une spécialisation en data science et IA enseignée par des chercheurs et des professionnels de l’industrie.

    Enseignements et compétences
    • Machine learning
    • Big data
    • Modélisation statistique
    • Aide à la décision par les données
    • Mathématiques appliquées
    • Optimisation
    • Bases de données relationnelles (SQL)
    • Gestion de projet
    • Innovation
    • Tronc commun généraliste : physique, sciences de l’ingénieur, informatique et économie
    • Projet d’intégration en data science

    Compétences Data Science, Big Data, Deep Learning, Apprentissage par renforcement, LLM, RAG, Dataiku

  2. 2019 – 2020

    Master 2 Mathématiques appliquées, Université de Lille

    Master de mathématiques appliquées obtenu en un an, en parallèle du diplôme d’ingénieur, dans le cadre d’un partenariat entre l’Université de Lille et Centrale Lille.

    Enseignements
    • Processus stochastiques : modélisation de phénomènes aléatoires qui évoluent dans le temps
    • Concentration de la mesure : probabilités en grande dimension, la théorie derrière les garanties de généralisation en machine learning
  3. 2017

    Licence de mathématiques, Université de Lille

    Licence de mathématiques appliquées préparée en parallèle de la première année à Centrale Lille, dans le cadre d’un partenariat entre l’Université de Lille et Centrale Lille.

    Enseignements
    • Topologie
    • Probabilités
    • Équations différentielles
    • Calcul différentiel
  4. 2014 – 2016

    Classes préparatoires MPSI / MP*, Ibn Ghazi

    Deux années intensives de mathématiques et de physique, avec des colles hebdomadaires, pour préparer les concours d’entrée aux grandes écoles d’ingénieurs françaises. Admis à Centrale Lille par le concours Centrale-Supélec.

    Enseignements
    • MPSI : analyse, algèbre, probabilités sur un univers fini, espaces préhilbertiens, équations différentielles linéaires
    • MP* (classe « étoile ») : réduction des matrices et théorème spectral, espaces vectoriels normés, séries entières, intégrales à paramètre, calcul différentiel, variables aléatoires discrètes et loi des grands nombres
    • Également physique, chimie, sciences de l’ingénieur et informatique (Python)

Certifications

  • Build and Modernize Applications With Generative AI Google Cloud Skills Boost, févr. 2026
  • Advanced Machine Learning on Google Cloud Specialization Coursera, mai 2021
  • Data Engineering, Big Data, and Machine Learning on GCP Specialization Coursera, mars 2021
  • Certified SAFe® 5 Practitioner Scaled Agile, Inc., déc. 2021 – déc. 2022
  • MOOC « Gestion de Projet » Centrale Lille
  • TOEIC TOEIC® Program

Langues

Français
Courant
Anglais
Courant
Arabe
Courant
Tamazight
Langue maternelle

Ma façon de construire

Une question, suivie à travers le type d’agent que je conçois. Le modèle planifie et explique, le code calcule, et rien n’est affirmé sans preuve.

Une question à travers le type d’agent que je construis
Question d’un analyste finance Plan le LLM choisit l’outil Requête SQL chiffres exacts, DuckDB Recherche docs BM25 + vecteurs, rerank Vérification assez de preuves ? Réponse sourcée chiffres et sources Question d’un analyste finance Plan le LLM choisit l’outil Requête SQL chiffres exacts, DuckDB Recherche docs BM25 + vecteurs, rerank Vérification assez de preuves ? Réponse sourcée chiffres et sources
  • Entrée ou sortie
  • Appel LLM
  • Code
  • Contrôle
  1. Question « Quelle région explique l’écart du T1, et qu’en dit la note budgétaire ? »
  2. Plan Le modèle décide quels outils peuvent répondre. Il n’écrit lui-même aucun chiffre.
  3. Requête SQL Une requête s’exécute sur les tables de l’analyste. L’écart par région revient exact.
  4. Recherche docs Recherche hybride dans les notes budgétaires : BM25 et vecteurs fusionnés, puis un cross-encoder ne garde que les meilleurs passages.
  5. Vérification Chaque chiffre renvoie à la requête, chaque affirmation à un passage. Si les preuves étaient minces, il le dirait.
  6. Réponse sourcée Deux phrases, un graphique en cascade et la page d’où vient chaque affirmation.

Les autres chemins du graphe

  • Pas de chiffres dans la question : le plan saute le SQL et ne cherche que dans les documents.
  • Preuves insuffisantes : retour au plan avec une meilleure requête, quelques tours au plus, puis une réponse qui dit ce qui manque.

Tous les projets

L’IA générative d’abord : un agent LLM construit chez Natixis, puis les systèmes RAG, les agents et les outils d’évaluation que je développe en dehors du travail, et deux produits de prévision et full-stack. Code source sur GitHub.

Chez BPCE & Natixis

RAG et systèmes LLM

  • Sanad RAG agentique sur des documents privés, où chaque affirmation renvoie à une page et à une boîte englobante. Étude de cas

    Lit neuf formats, y compris les scans et les photos via un OCR par vision ; découpe en chunks selon la structure, sans jamais couper une ligne de tableau ; ajoute le Contextual Retrieval. Recherche hybride BM25 + vecteurs fusionnée par RRF, puis rerank par cross-encoder : sur le corpus d’exemple, le MRR d’un modèle d’embedding faible passe de 0,53 à 0,94. Un agent LangGraph reformule les questions de suivi, décompose les questions à plusieurs volets, critique ses propres preuves et s’abstient plutôt que de deviner. Chaque citation est vérifiée contre son chunk source, et un banc d’évaluation mesure le rappel, le MRR et l’ancrage dans les sources (groundedness) pour chaque modèle. L’ingestion se met en pause et reprend en plein fichier sans jamais payer deux fois le même appel.

    Construit avec LangGraph, FastAPI, recherche hybride BM25 + vecteurs (RRF), rerank par cross-encoder, OCR par vision Claude, ChromaDB, SQLite FTS5, pipelines avec pause et reprise, Angular

  • Applied LLM Projects Monorepo de cinq systèmes LLM derrière une passerelle unique à découverte automatique, avec un suivi des coûts unifié.

    Un agent SQL à appel de fonctions avec garde-fous, un banc d’évaluation RAG (recall@k, groundedness notée par un LLM juge, ablations sur le chunking), un narrateur de prévisions avec backtests à origine glissante, une sentinelle de dérive avec triage du petit modèle vers le grand, et un pipeline de distillation qui mesure une frontière de Pareto précision/coût.

    Construit avec passerelle FastAPI, modèles locaux compatibles OpenAI et tous les grands fournisseurs de LLM, évaluations RAG, distillation, suivi des coûts, Angular

Agents LLM et évaluation

Prévision et produits full-stack

  • Vantage / Insight Terminal Plateforme full-stack de veille de marché couvrant ~194 instruments : actions, crypto et futures sur matières premières.

    Un ensemble XGBoost, LightGBM, LSTM PyTorch, ARIMA et Prophet confronté à des baselines naïves par un backtesting walk-forward honnête, un sentiment d’actualité noté par LLM, et une note quotidienne rédigée par IA, servie par un modèle local compatible OpenAI.

    Construit avec FastAPI, SQLModel, PyTorch LSTM, XGBoost/LightGBM, ARIMA/Prophet, backtesting walk-forward, Angular

  • Tahanot ERP Mini-ERP auto-hébergé inspiré d’Odoo (ventes, achats, stocks, dashboard), reconstruit de zéro. Étude de cas

    Un registre de modèles générique avec filtres de domaine, des documents pilotés par machine à états, un stock géré par quants avec reliquats, des variantes de produits, les paiements de factures et les avoirs, plus un assistant IA à appel d’outils branché sur la couche de services. Bilingue EN/FR, avec des tests de concurrence et de verrouillage sur Postgres.

    Construit avec FastAPI, SQLAlchemy, PostgreSQL, Alembic, Docker, assistant à appel d’outils, React

Compétences

  • IA générative & LLM
  • RAG & agents IA
  • Évaluation de LLM
  • Prompt engineering
  • Machine learning
  • Vision par ordinateur
  • NLP
  • MLOps

Technologies

IA générative & LLM
LangGraph, LangChain, Hugging Face, API LLM (Claude, Gemini, compatibles OpenAI), ChromaDB, spaCy, NLTK
Code
Python, Scala, SQL, JavaScript
ML & deep learning
PyTorch, TensorFlow, Keras, JAX, Haiku, scikit-learn, XGBoost, LightGBM
Applications IA & API
FastAPI, Chainlit, Streamlit, React, Angular
Données
Pandas, Polars, Apache Spark, Hadoop, DuckDB
Bases de données & recherche
SQL / NoSQL, PostgreSQL, Impala, MongoDB, Cassandra, Elasticsearch
Plateformes
Docker, Kubernetes, OpenShift, Jenkins, GCP (Vertex AI), Dataiku

Méthodes

IA générative
agents et appel d’outils, RAG avec recherche hybride (BM25 + vecteurs + RRF), reranking, évaluation de LLM et notation par LLM juge, versionnage de prompts et A/B testing
Machine learning
OCR, détection d’objets (YOLO), reconnaissance vocale (Whisper), prévision de séries temporelles
Ingénierie
pipelines ETL, CI/CD, Git, Agile (SAFe, Scrum)

Interrogez ce CV

Posez une question. Un classement BM25, la moitié lexicale de la recherche de Sanad, note chaque passage de ce site dans votre navigateur et répond avec les passages eux-mêmes : il ne peut donc rien inventer.

Les 3 meilleurs passages sur 52, classés par BM25

  1. Compétences : IA générative score 3.48

    agents et appel d’outils, RAG avec recherche hybride (BM25 + vecteurs + RRF), reranking, évaluation de LLM et notation par LLM juge, versionnage de prompts et A/B testing.

  2. Projet : Applied LLM Projects score 2.74

    Monorepo de cinq systèmes LLM derrière une passerelle unique à découverte automatique, avec un suivi des coûts unifié. Un agent SQL à appel de fonctions avec garde-fous, un banc d’évaluation RAG (recall@k, groundedness notée par un LLM juge, ablations sur le chunking), un narrateur de prévisions …

  3. Projet : Insight Generator score 2.74

    Agent LLM pour les feuilles de calcul de la finance : données propres, pivots exacts, réponses calculées en SQL. Les équipes finance importent des exports Excel ou CSV ; l’outil détecte le format réel, interprète les valeurs financières françaises et anglaises, signale les problèmes de qualité, …

Essayez

À propos

Je m’appelle Hamza Ouhssaine. Le tamazight est ma langue maternelle, et je travaille en français, en anglais et en arabe.

J’ai étudié les mathématiques en MP* à Ibn Ghazi, puis à Centrale Lille, avec en parallèle un master de mathématiques appliquées à l’Université de Lille.

J’ai commencé par la recherche, à détecter des données cachées dans des images au laboratoire CRIStAL, puis j’ai construit des API d’OCR et de détection de fraude chez Meelo. Chez Amadeus, j’ai développé les pipelines de données sur lesquels repose le revenue management des compagnies aériennes, et piloté les recrutements de l’équipe.

Chez ArcelorMittal, j’ai installé la vision par ordinateur sur la ligne d’acier : lecture des identifiants produits avec un taux d’erreur par caractère de 0,098 %.

Depuis 2026, je conçois de l’IA générative pour la finance chez BPCE & Natixis : des agents qui calculent au lieu de deviner, et des réponses qui citent leurs sources.

Hamza Ouhssaine Ingénieur IA générative & Data Scientist senior

Vous construisez quelque chose de ce genre ? Écrivez-moi.

hamzaouhssaine@gmail.com
Les deux tours de verre inclinées des Tours Duo à Paris, la plus haute portant l’enseigne Groupe BPCE, au-dessus des voies ferrées.

Contact

Un projet d’IA générative, de RAG ou de machine learning en tête ? L’e-mail est le moyen le plus rapide de me joindre.

Basé à Paris, France. Mobile géographiquement.

Langues
Français, Anglais, Arabe, Tamazight
M’écrire